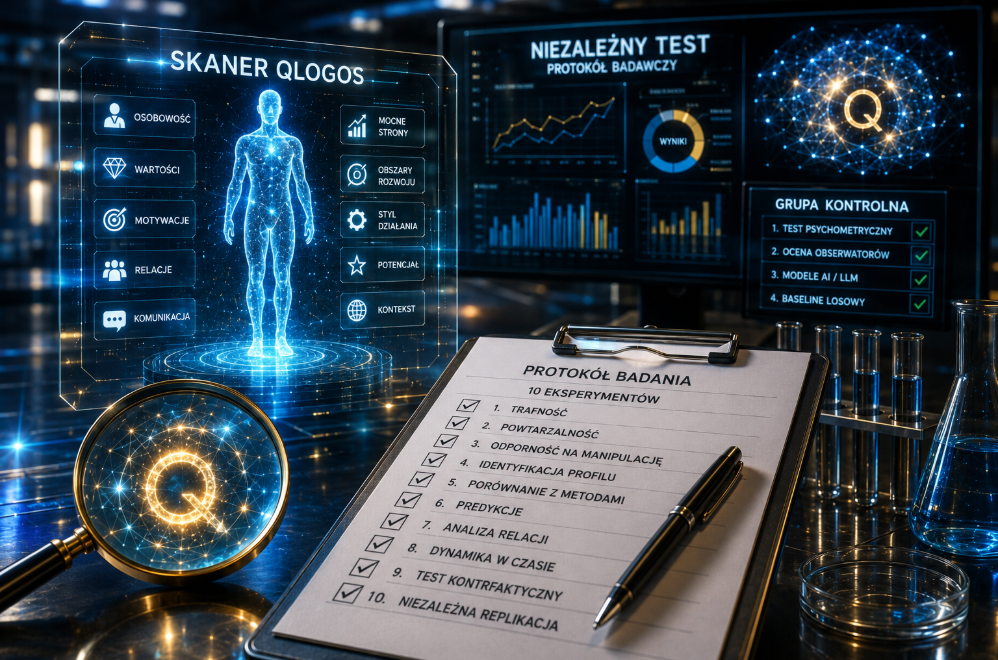
Protokół niezależnego testu Skanera QLogos
Niezależny test Skanera QLogos to propozycja praktycznej procedury, której celem jest sprawdzenie, czy deklarowane możliwości Skanera można potwierdzić w sposób obiektywny, powtarzalny i możliwy do niezależnej kontroli.
Poświęciliśmy już wcześniejsze artykuły Teorii Q, koncepcji QAI oraz samemu Skanerowi QLogos. Pojawiło się jednak pytanie ważniejsze od wszystkich opinii: jak właściwie sprawdzić, czy Skaner rzeczywiście robi to, co deklarują jego twórcy?
Ten artykuł jest próbą udzielenia na to pytanie konkretnej odpowiedzi.
Ten dokument można potraktować jako propozycję oficjalnego protokołu badawczego dla QLogos.
Nie zakłada on z góry, że Skaner działa albo nie działa.
Określa natomiast, co należy zmierzyć, z czym porównać wynik, jak przyznawać punkty oraz jaki wynik uznać za potwierdzający lub osłabiający określoną hipotezę.
1. Dlaczego potrzebny jest niezależny test?
W przypadku każdego narzędzia deklarującego możliwość trafnego opisywania człowieka trzeba rozdzielić trzy różne kwestie.
- Opis brzmi trafnie.
- Opis rzeczywiście odpowiada mierzalnym właściwościom człowieka.
- System osiąga wynik lepszy od odpowiednich metod kontrolnych.
Pierwsza sytuacja może wystąpić nawet wtedy, gdy opis jest bardzo ogólny.
Druga wymaga porównania z niezależnym kryterium.
Trzecia wymaga już eksperymentu porównawczego.
Dlatego samo stwierdzenie użytkownika:
jest wartościową informacją – nie rozstrzyga jeszcze kwestii naukowej skuteczności systemu.
2. Cel testu
Celem proponowanego badania jest odpowiedź na sześć podstawowych pytań:
- Czy Skaner trafnie opisuje określone właściwości badanej osoby?
- Czy wyniki Skanera są powtarzalne?
- Czy wyniki pozostają użyteczne, gdy badany próbuje świadomie wpłynąć na rezultat?
- Czy Skaner odróżnia konkretne osoby od innych osób?
- Czy Skaner daje wyniki lepsze niż wcześniej zdefiniowane metody kontrolne?
- Czy jego wynik posiada wartość predykcyjną, czyli pozwala przewidywać wcześniej zdefiniowane zachowania lub zmiany?
3. Czego ten test NIE ma udowadniać?
❌Protokół nie ma udowadniać całej Teorii Q jednym eksperymentem.
❌Nie ma również rozstrzygać, czy wszystkie twierdzenia dotyczące QAI są prawdziwe.
Test dotyczy przede wszystkim konkretnych, mierzalnych właściwości Skanera.
Jeżeli Skaner osiągnie bardzo dobre wyniki, będzie to argument przemawiający za jego skutecznością.
❌Nie będzie to jednak automatyczne potwierdzenie wszystkich założeń Teorii Q.
Analogicznie, słaby wynik jednego testu nie musi oznaczać automatycznego obalenia całej Teorii Q.
4. Główna hipoteza badawcza
H1: Skaner QLogos potrafi na podstawie danych wejściowych wygenerować charakterystykę osoby, która jest istotnie trafniejsza, bardziej powtarzalna i bardziej użyteczna niż wyniki uzyskiwane przez odpowiednio dobrane metody kontrolne.
Hipoteza ta musi zostać rozbita na mniejsze hipotezy, ponieważ dopiero wtedy można sprawdzić, który element rzeczywiście działa.
5. Hipotezy szczegółowe
| Symbol | Hipoteza | Co sprawdzamy? |
|---|---|---|
| H1 | Trafność | Czy profil odpowiada rzeczywistym cechom osoby? |
| H2 | Powtarzalność | Czy ponowne badanie daje porównywalny wynik? |
| H3 | Odporność | Czy wynik jest odporny na świadomą manipulację? |
| H4 | Identyfikacja | Czy można wskazać właściwy profil spośród innych? |
| H5 | Przewaga | Czy Skaner przewyższa modele kontrolne? |
| H6 | Predykcja | Czy wynik pozwala przewidzieć określone zdarzenia? |
6. Proponowana grupa badawcza
Dla pierwszej pilotażowej wersji badania proponujemy minimum 120 osób.
Próba powinna być możliwie zróżnicowana pod względem wieku, płci, zawodu, wykształcenia, stylu komunikacji i sytuacji życiowej.
Nie chodzi o stworzenie reprezentatywnej próby całej populacji Polski. Chodzi o to, aby wynik nie był uzależniony od bardzo jednorodnej grupy.
| Grupa | Liczba | Cel |
|---|---|---|
| Badani | 120 | Główna próba |
| Kontrola niezależna | 120 | Porównanie metod |
| Retest | minimum 60 | Powtarzalność |
Jeżeli koszty lub dostępność uczestników uniemożliwiają wykonanie pełnego badania, można rozpocząć od pilotażu obejmującego 30–50 osób, ale jego wynik należy traktować wyłącznie jako test wstępny, a nie ostateczne potwierdzenie skuteczności.
7. Grupa kontrolna
Grupa kontrolna jest jednym z najważniejszych elementów całego protokołu.
Skaner powinien zostać porównany z co najmniej trzema punktami odniesienia:
- standardowym narzędziem psychometrycznym dobranym przez niezależnego eksperta,
- oceną osób znających badanego,
- modelami AI lub LLM, którym podane zostaną dokładnie te same informacje wejściowe.
Dodatkowo należy zastosować baseline losowy, czyli wynik odpowiadający przewidywaniom losowym.
Zasada porównania:
Jeżeli Skaner osiąga 80% trafności, nie możemy jeszcze powiedzieć, że działa wyjątkowo dobrze. Musimy wiedzieć, czy metoda kontrolna osiąga 50%, 70%, 79% czy 90%.
8. Zasada identycznych danych wejściowych
Aby porównanie było uczciwe, każdy system musi otrzymać ten sam materiał wejściowy.
Jeżeli Skaner otrzymuje pełny profil osoby, a model kontrolny jedynie krótką wypowiedź, porównanie będzie metodologicznie niewłaściwe.
Dlatego przed rozpoczęciem testu należy stworzyć jeden zamknięty pakiet danych.
PAKIET DANYCH OSOBY:
- ustandaryzowane odpowiedzi,
- wybrane próbki wypowiedzi,
- opis określonych zachowań,
- dane dotyczące kontekstu – tylko w zakresie wcześniej ustalonym,
- informacje demograficzne – jeżeli są elementem badania.
Żaden system nie powinien otrzymywać dodatkowych informacji, których nie otrzymują pozostałe systemy.
9. Test nr 1 – trafność opisu
Pierwszym zadaniem jest ustalenie, czy wynik Skanera odpowiada rzeczywistości.
Dla każdej osoby należy zdefiniować przed rozpoczęciem badania od 10 do 20 mierzalnych cech lub zachowań.
Przykładowe pytania:
- Czy osoba preferuje podejmowanie decyzji samodzielnie?
- Czy w sytuacji konfliktu częściej konfrontuje problem czy go unika?
- Czy łatwo zmienia stanowisko pod wpływem argumentów innych osób?
- Czy preferuje działanie spontaniczne czy planowanie?
- Czy w relacjach zwraca większą uwagę na emocje czy na fakty?
- Czy w sytuacji presji zachowuje stabilność decyzji?
- Czy preferuje ryzyko czy bezpieczeństwo?
- Czy łatwo inicjuje kontakt z obcymi osobami?
- Czy jest skłonna zmieniać strategię po niepowodzeniu?
- Czy w konflikcie koncentruje się bardziej na rozwiązaniu czy na obronie własnego stanowiska?
Pytania muszą być przygotowane przed analizą wyników Skanera.
10. Skala oceny pojedynczego twierdzenia
Każde twierdzenie zawarte w profilu Skanera oceniane jest przez niezależnego oceniającego według pięciostopniowej skali:
| Ocena | Znaczenie |
|---|---|
| 0 | Twierdzenie zdecydowanie niezgodne z rzeczywistością |
| 1 | Raczej niezgodne |
| 2 | Nie można jednoznacznie ocenić |
| 3 | Raczej zgodne |
| 4 | Zdecydowanie zgodne |
11. Punktacja trafności
Dla każdego profilu obliczamy średnią ocenę wszystkich weryfikowanych twierdzeń.
Maksymalny wynik wynosi 4,00 punktu.
| Wynik | Interpretacja |
|---|---|
| 0,00–1,49 | niska trafność |
| 1,50–2,49 | trafność niejednoznaczna |
| 2,50–2,99 | umiarkowana trafność |
| 3,00–3,49 | wysoka trafność |
| 3,50–4,00 | bardzo wysoka trafność |
Powyższe progi są proponowaną skalą tego protokołu, a nie istniejącym standardem naukowym. Ich wartość powinna zostać ustalona przed rozpoczęciem badania i nie może być zmieniana po poznaniu wyników.
12. Test nr 2 – czy Skaner rozpoznaje właściwą osobę?
To jeden z najbardziej przekonujących testów praktycznych.
Każdy uczestnik otrzymuje pięć anonimowych profili:
- swój profil,
- profil osoby podobnej,
- profil osoby odmiennej,
- profil losowy,
- profil kontrolny.
Uczestnik nie wie, który profil został wygenerowany dla niego.
Następnie odpowiada na pytanie:
„Który z poniższych profili najlepiej opisuje Ciebie?”
Wynik należy porównać z prawdopodobieństwem przypadkowego wyboru.
Przy pięciu profilach przypadkowy wybór daje około 20% prawidłowych wskazań.
13. Warunek zaliczenia testu identyfikacyjnego
Proponowany warunek:
Test uznaje się za zaliczony wstępnie, jeżeli prawidłowe wskazania własnego profilu przekroczą 50% oraz wynik będzie statystycznie istotnie lepszy od poziomu losowego.
Nie jest to próg „prawdy absolutnej”. Jest to wcześniej zdefiniowane kryterium decyzyjne dla tego eksperymentu.
14. Test nr 3 – powtarzalność
Minimum 60 uczestników wykonuje Skaner ponownie:
- pierwszy raz – T1,
- po 7 dniach – T2,
- po 30 dniach – T3.
Porównujemy odpowiedzi i wynik końcowy.
Nie oczekujemy, że każdy element pozostanie identyczny. Jeżeli Skaner opisuje dynamiczne właściwości człowieka, pewne zmiany mogą być naturalne.
Musimy jednak ustalić, które elementy mają być stabilne, a które mogą się zmieniać.
15. Warunek zaliczenia testu powtarzalności
Przed rozpoczęciem badania należy określić, jaki poziom zgodności jest wymagany.
Proponujemy, aby:
minimum 80% wcześniej zdefiniowanych stabilnych elementów profilu wykazywało wysoką zgodność między pomiarami.
Do oceny należy zastosować odpowiednią miarę statystyczną, a nie jedynie subiektywne wrażenie badacza.
16. Test nr 4 – odporność na manipulację
Jeżeli Skaner ma rozpoznawać głębsze właściwości osoby, należy sprawdzić, co dzieje się wtedy, gdy badany próbuje świadomie wpłynąć na wynik.
Tworzymy trzy grupy:
| Grupa | Instrukcja |
|---|---|
| A | Odpowiadaj zgodnie z prawdą. |
| B | Staraj się celowo stworzyć fałszywy obraz siebie. |
| C | Odpowiadaj spontanicznie, bez dodatkowej instrukcji. |
Porównujemy, jak bardzo zmieniają się wyniki oraz czy Skaner potrafi wykryć niespójność.
17. Pytania do testu odporności
- Czy świadome kłamstwo znacząco zmienia wynik?
- Czy system wykrywa niespójność odpowiedzi?
- Czy potrafi wskazać obszary, w których odpowiedzi są niewiarygodne?
- Czy zmiana wyniku odpowiada faktycznej zmianie odpowiedzi?
- Czy system jest odporny na strategie „idealizowania siebie”?
18. Test nr 5 – Skaner kontra człowiek
Skaner powinien zostać porównany z oceną osób, które dobrze znają badanego.
Dla każdego uczestnika można wskazać trzy osoby:
- partnera lub partnerkę,
- bliskiego przyjaciela,
- współpracownika lub przełożonego.
Każda z tych osób otrzymuje identyczny zestaw pytań dotyczących badanego.
Następnie porównujemy zgodność:
SKANER ↔ BADANY ↔ OBSERWATORZY
Jeżeli Skaner osiąga zgodność z niezależnymi obserwatorami większą niż pojedynczy obserwator oraz modele kontrolne, jest to istotny wynik.
19. Test nr 6 – Skaner kontra AI
To jeden z najważniejszych elementów całego protokołu w kontekście deklarowanego potencjału QAI.
Skaner otrzymuje określony zestaw danych.
Dokładnie ten sam zestaw otrzymują niezależne systemy AI.
Każdy system odpowiada na identyczne pytania.
Przykładowe pytania:
- Jakie są trzy najbardziej prawdopodobne mocne strony tej osoby?
- Jakie są trzy najbardziej prawdopodobne trudności w relacjach?
- Jak osoba prawdopodobnie zachowa się pod presją?
- Jakiego typu decyzje może preferować?
- Jakie informacje mogą spowodować zmianę jej stanowiska?
- Jakie zachowanie jest najbardziej prawdopodobne w sytuacji konfliktowej?
Najważniejsza zasada: pytania i kryteria oceny muszą być ustalone przed porównaniem wyników.
20. Czy Grok powinien zostać wykorzystany jako kontrola?
Tak – ale nie jako autorytet.
Jeżeli w publicznych materiałach sztuczna inteligencja Grok wyraża opinię na temat Skanera, można wykorzystać Groka jako jeden z systemów porównawczych.
Nie należy jednak traktować jego opinii jako dowodu skuteczności Skanera.
Opinia AI o Skanerze jest informacją. Wynik kontrolowanego eksperymentu jest dowodem empirycznym.
Grok, ChatGPT, Claude lub inne systemy mogą zostać potraktowane jako uczestnicy benchmarku – pod warunkiem, że otrzymają identyczne dane i identyczne zadania.
21. Test nr 7 – predykcja
Największą wartość poznawczą miałby test sprawdzający, czy Skaner potrafi przewidywać wcześniej określone zachowania.
Przykładowo Skaner analizuje osobę w dniu 1.
Na podstawie analizy formułuje pięć precyzyjnych przewidywań na kolejne 30 dni.
Przewidywania muszą zostać:
- zapisane przed rozpoczęciem obserwacji,
- opatrzone datą i godziną,
- zabezpieczone przed późniejszą zmianą,
- jednoznacznie zdefiniowane,
- mierzalne.
22. Przykład dobrej i złej predykcji
Predykcja słaba:
„W najbliższym czasie osoba może znaleźć się w sytuacji wymagającej ważnej decyzji.”
Dlaczego jest słaba?
Nie wiadomo dokładnie, czym jest „najbliższy czas”, „ważna decyzja” ani co oznacza znalezienie się w takiej sytuacji.
Predykcja dobra:
„W okresie od 1 do 30 listopada osoba podejmie decyzję dotyczącą zmiany pracy lub zakresu wykonywanych obowiązków zawodowych.”
Dlaczego jest lepsza?
Ma określony czas, zdarzenie i kryterium zaliczenia.
23. Punktacja predykcji
| Wynik | Ocena |
|---|---|
| 0 | predykcja nietrafiona |
| 1 | predykcja częściowo trafiona według wcześniej ustalonego kryterium |
| 2 | predykcja jednoznacznie trafiona |
Przy pięciu predykcjach maksymalny wynik wynosi 10 punktów.
24. Warunek zaliczenia testu predykcyjnego
Proponowany warunek:
Średni wynik predykcyjny Skanera powinien być istotnie wyższy od wyniku osiąganego przez wcześniej zdefiniowane modele kontrolne i baseline losowy.
W tym eksperymencie nie należy ustalać progu dopiero po poznaniu wyników.
25. Test nr 8 – analiza relacji dwóch osób
Jeżeli jednym z potencjalnych wyróżników podejścia QLogos jest szczególne znaczenie relacji i kontekstu, należy sprawdzić tę deklarację bezpośrednio.
Tworzymy pary osób, które pozostają w rzeczywistej relacji.
Skaner otrzymuje dane dotyczące:
- osoby A,
- osoby B,
- ich komunikacji,
- historii określonych interakcji,
- kontekstu relacji.
Następnie system odpowiada na wcześniej przygotowane pytania:
- Jaki jest główny obszar napięcia?
- Jakiego rodzaju nieporozumienie pojawia się najczęściej?
- Jak każda z osób może interpretować zachowanie drugiej?
- Jaki typ komunikatu może zwiększyć napięcie?
- Jaki typ komunikatu może zmniejszyć napięcie?
- Jakie zachowanie każdej ze stron jest najbardziej prawdopodobne w określonej sytuacji?
26. Test nr 9 – człowiek jako proces
Jeżeli człowiek jest traktowany jako dynamiczny układ, jednorazowy pomiar może nie być wystarczający.
Dlatego proponujemy obserwację:
T1 → T2 → T3 → T4 → T5 → T6
W każdym punkcie czasowym system wykonuje analizę.
Następnie sprawdzamy:
- co się zmieniło,
- co pozostało stabilne,
- czy system wykrył zmianę wcześniej niż obserwatorzy,
- czy wykryta zmiana odpowiada rzeczywistym wydarzeniom.
27. Test nr 10 – kontrfaktyczny
Najbardziej wymagającym eksperymentem byłoby sprawdzenie, czy model potrafi przewidzieć konsekwencje hipotetycznej zmiany.
Przykład:
Stan początkowy: osoba A i osoba B funkcjonują w określonym modelu relacji.
Zmiana: usuwamy lub zmieniamy jeden z istotnych elementów.
Pytanie: jaki wpływ będzie miała ta zmiana na dalszą dynamikę relacji?
Jeżeli Skaner potrafiłby wykonywać takie predykcje skuteczniej niż modele kontrolne, byłby to bardzo interesujący rezultat wymagający dalszych badań.
28. Łączna karta punktacji
| Obszar | Maks. punkty | Wynik |
|---|---|---|
| Trafność profilu | 20 | _____ |
| Identyfikacja własnego profilu | 20 | _____ |
| Powtarzalność | 20 | _____ |
| Odporność na manipulację | 20 | _____ |
| Predykcja | 20 | _____ |
| RAZEM | 100 | _____ |
Powyższa karta ma charakter organizacyjny. Nie zastępuje analizy statystycznej poszczególnych eksperymentów.
29. Proponowana interpretacja wyniku
| Wynik | Interpretacja |
|---|---|
| 0–39 | brak wystarczających podstaw do potwierdzenia hipotezy |
| 40–59 | wynik niejednoznaczny |
| 60–74 | wynik obiecujący, wymagający dalszej weryfikacji |
| 75–89 | silne przesłanki skuteczności |
| 90–100 | bardzo silny wynik wymagający niezależnej replikacji |
Uwaga: nie należy interpretować wyniku 90/100 jako automatycznego „udowodnienia Teorii Q”. Oznaczałby on bardzo interesujący rezultat konkretnego protokołu.
30. Warunki konieczne do uznania testu za wiarygodny
Aby wynik miał rzeczywistą wartość, przed rozpoczęciem badania należy spełnić następujące warunki:
- hipotezy są zapisane przed badaniem,
- kryteria sukcesu są ustalone przed badaniem,
- nie zmienia się pytań po poznaniu wyników,
- grupa kontrolna jest określona wcześniej,
- dane wejściowe są identyczne dla porównywanych systemów,
- osoby oceniające nie wiedzą, który system wygenerował wynik,
- wyniki są archiwizowane,
- odnotowywane są również błędy,
- analiza obejmuje całą próbę, a nie wybrane przypadki,
- badanie można powtórzyć.
31. Podwójna ślepa ocena
W miarę możliwości osoby oceniające powinny nie wiedzieć:
- czy analizują wynik Skanera,
- czy analizują wynik innego modelu,
- czy opis dotyczy osoby, którą znają,
- jaki wynik badacz spodziewa się uzyskać.
Pozwala to ograniczyć efekt oczekiwań.
Jeżeli wynik Skanera rzeczywiście jest wyjątkowo trafny, powinien pozostać trafny również wtedy, gdy osoba oceniająca nie wie, skąd pochodzi analizowany profil.
32. Co zrobić z przypadkami błędnymi?
To jeden z najważniejszych warunków uczciwego badania.
Nie wolno usuwać błędnych wyników tylko dlatego, że „Skaner miał gorszy dzień”.
Każdy przypadek musi zostać zapisany.
Należy stworzyć osobną kategorię:
PRZYPADEK, W KTÓRYM SKANER SIĘ POMYLIŁ
Następnie należy sprawdzić, czy błędy mają wspólną przyczynę.
33. Formularz uczestnika – zgoda na badanie
FORMULARZ A – UCZESTNIK BADANIA
Numer uczestnika: ______________________________
Data badania: ______________________________
Wiek: ______________________________
Zawód / obszar aktywności: ______________________________
Potwierdzam, że dobrowolnie uczestniczę w badaniu dotyczącym działania Skanera QLogos oraz zostałem/am poinformowany/a o celu badania, sposobie wykorzystania danych i możliwości rezygnacji z udziału zgodnie z zasadami określonymi przez organizatora badania.
Zgoda uczestnika: TAK / NIE
Podpis: ______________________________
34. Formularz B – ocena profilu Skanera
FORMULARZ B – NIEZALEŻNA OCENA
Numer badanego: ______________________________
Numer profilu: ______________________________
Oceń każde twierdzenie w skali 0–4.
| Twierdzenie | 0 | 1 | 2 | 3 | 4 |
|---|---|---|---|---|---|
| 1. ______________________________ | □ | □ | □ | □ | □ |
| 2. ______________________________ | □ | □ | □ | □ | □ |
| 3. ______________________________ | □ | □ | □ | □ | □ |
| 4. ______________________________ | □ | □ | □ | □ | □ |
| 5. ______________________________ | □ | □ | □ | □ | □ |
Średnia ocena: __________ / 4,00
Uwagi:
____________________________________________________________
____________________________________________________________
35. Formularz C – identyfikacja własnego profilu
FORMULARZ C – TEST ŚLEPY
Przedstawiono mi pięć anonimowych profili.
Który z nich najlepiej opisuje mnie?
Wybrany profil: A / B / C / D / E
Pewność wyboru:
0 – żadna 1 – niska 2 – średnia 3 – wysoka 4 – bardzo wysoka
Ocena: __________ / 4
36. Formularz D – test predykcyjny
FORMULARZ D – PREDYKCJE ZAPISANE PRZED OBSERWACJĄ
Numer uczestnika: ______________________________
Data wygenerowania predykcji: ______________________________
| Nr | Predykcja | Termin | Wynik 0–2 |
|---|---|---|---|
| 1 | ________________ | ________ | ____ |
| 2 | ________________ | ________ | ____ |
| 3 | ________________ | ________ | ____ |
| 4 | ________________ | ________ | ____ |
| 5 | ________________ | ________ | ____ |
Łączny wynik: __________ / 10
37. Formularz E – porównanie systemów AI
FORMULARZ E – BENCHMARK AI
Numer zadania: ______________________________
System: Skaner / AI-1 / AI-2 / AI-3 / baseline
Identyczne dane wejściowe: TAK / NIE
Odpowiedź:
____________________________________________________________
____________________________________________________________
Ocena niezależnego eksperta: ______ / 10
Ocena trafności: ______ / 10
Ocena użyteczności: ______ / 10
38. Formularz F – końcowy raport dla QLogos
RAPORT NIEZALEŻNEGO TESTU SKANERA QLOGOS
Data rozpoczęcia: ______________________________
Data zakończenia: ______________________________
Liczba uczestników: ______________________________
Wersja Skanera: ______________________________
Wersja / konfiguracja systemu: ______________________________
Osoby odpowiedzialne za test:
____________________________________________________________
Główne wyniki:
____________________________________________________________
____________________________________________________________
Najważniejsze błędy:
____________________________________________________________
____________________________________________________________
Wynik końcowy: __________ / 100
Czy kryterium sukcesu zostało spełnione? TAK / NIE / NIEJEDNOZNACZNE
Czy wynik został powtórzony niezależnie? TAK / NIE
Uwagi QLogos:
____________________________________________________________
____________________________________________________________
39. Co QLogos powinno udostępnić przed rozpoczęciem testu?
Aby test był rzeczywiście niezależny, twórcy Skanera powinni przed rozpoczęciem badania określić:
- co dokładnie jest mierzone,
- jakie są dane wejściowe,
- jak powstaje wynik,
- które elementy profilu są stabilne,
- które elementy mogą się zmieniać,
- jakie są znane ograniczenia systemu,
- jakie są przewidywane błędy,
- jakie są warunki, w których system nie powinien być stosowany.
Nie oznacza to konieczności ujawnienia całego kodu źródłowego. Oznacza natomiast konieczność wystarczającego opisania procedury, aby niezależny zespół mógł ją uczciwie ocenić.
40. Najważniejsza zasada: żadnego dopasowywania wyniku po fakcie
Jeżeli Skaner wygeneruje profil, który nie pasuje do badanego, nie można po fakcie zmienić interpretacji tak, aby jednak uznać go za trafny.
Jeżeli predykcja nie spełniła wcześniej ustalonego kryterium, należy uznać ją za nietrafioną.
Największym wrogiem tego badania byłoby „dopasowanie po fakcie”.
Dlatego kryteria muszą zostać ustalone przed rozpoczęciem eksperymentu.
41. Niezależność zespołu badawczego
Najlepszym rozwiązaniem byłoby powołanie zespołu składającego się z:
- przedstawiciela QLogos,
- niezależnego metodologa badań,
- specjalisty psychometrii lub psychologii,
- specjalisty AI / uczenia maszynowego,
- osoby odpowiedzialnej za analizę statystyczną.
Każda strona powinna mieć dostęp do tych samych danych i tych samych wyników.
42. Publikacja wyników
Raport końcowy powinien zawierać nie tylko wyniki pozytywne.
Powinien zawierać również:
- wszystkie nieudane predykcje,
- przypadki błędnej identyfikacji,
- przypadki niespójności,
- wyniki grup kontrolnych,
- metody obliczeniowe,
- ograniczenia badania.
Dopiero pełny raport umożliwi niezależną ocenę.
43. Co będzie wynikiem pozytywnym?
Wynikiem pozytywnym nie będzie samo uzyskanie wysokiej średniej oceny.
Najbardziej przekonujący byłby układ, w którym Skaner:
- uzyskuje wysoką trafność,
- jest powtarzalny,
- rozpoznaje właściwe profile lepiej niż przypadek,
- utrzymuje wyniki na nowych danych,
- przewyższa odpowiednio dobrane modele kontrolne,
- wykazuje przewagę również w analizie relacji,
- uzyskuje podobne wyniki w niezależnej replikacji.
44. Co będzie wynikiem negatywnym?
Za wynik osłabiający hipotezę należy uznać sytuację, w której:
- trafność nie przekracza poziomu kontroli,
- wyniki są niestabilne,
- system nie odróżnia własnych profili od przypadkowych,
- predykcje nie są lepsze od modeli kontrolnych,
- system traci skuteczność na nowych danych,
- wyniki nie dają się niezależnie powtórzyć.
45. A co, jeśli wynik będzie częściowo pozytywny?
To może być najbardziej interesujący rezultat.
Skaner może na przykład:
- bardzo dobrze opisywać określone cechy,
- gorzej przewidywać zachowania,
- dobrze analizować relacje,
- nie wykazywać przewagi nad najlepszymi modelami AI w innych zadaniach.
W takim przypadku nie należy mówić ani „Skaner został udowodniony”, ani „Skaner został obalony”.
Należy powiedzieć:
Określone elementy koncepcji uzyskały potwierdzenie, inne wymagają dalszych badań.
46. Czy taki test może zweryfikować potencjał QAI?
Tak – ale tylko częściowo.
Jeżeli Skaner rzeczywiście wykorzystuje określone założenia Teorii Q, a następnie osiąga przewagę nad istniejącymi metodami w zadaniach związanych z człowiekiem, relacjami i kontekstem, otrzymujemy istotną przesłankę na rzecz dalszego rozwoju tego kierunku.
Nie byłby to jednak jeszcze dowód, że powstała całkowicie nowa generacja sztucznej inteligencji.
Aby taką tezę uzasadnić, trzeba przeprowadzić osobny benchmark technologiczny obejmujący architekturę, efektywność, generalizację, koszty obliczeniowe, jakość wyników oraz niezależną replikację.
47. Najważniejszy eksperyment przyszłości – QAI kontra współczesne AI
Jeżeli QLogos chce wykazać, że Teoria Q może prowadzić do nowej generacji AI, najbardziej przekonującym rozwiązaniem byłoby przygotowanie publicznego benchmarku.
W tym benchmarku:
- QAI otrzymuje dane wejściowe,
- LLM otrzymują identyczne dane,
- zadania są identyczne,
- kryteria oceny są identyczne,
- wyniki są oceniane przez niezależnych ekspertów,
- test jest wykonywany na nowych danych.
Dopiero wtedy można rozpocząć poważną dyskusję o technologicznej przewadze QAI.
48. Oficjalne zaproszenie dla Piotra Tymochowicza i QLogos
PROPOZYCJA WSPÓLNEGO TESTU
Piotrze Tymochowiczu, QLogos – jeżeli Skaner rzeczywiście posiada deklarowane możliwości, proponujemy je wspólnie sprawdzić.
Nie oczekujemy przyjęcia z góry żadnej tezy.
Nie oczekujemy również, że wynik musi być pozytywny.
Proponujemy stworzenie warunków, w których wynik będzie mógł przemówić sam za siebie.
Udostępniamy protokół, pytania, kryteria, skalę ocen, sposób punktacji oraz formularze.
QLogos może wskazać własne uwagi metodologiczne i zaproponować modyfikacje, ale wszystkie zmiany powinny zostać zaakceptowane przed rozpoczęciem testu.
49. Minimalne warunki oficjalnego rozpoczęcia testu
Przed pierwszym badaniem strony powinny podpisać wspólny dokument zawierający:
- ostateczną wersję hipotez,
- liczbę uczestników,
- metody kontroli,
- pytania badawcze,
- skalę ocen,
- kryteria zaliczenia,
- zasady przetwarzania danych,
- zasady publikacji wyników,
- zasady niezależnej replikacji.
Od tego momentu żadna ze stron nie powinna zmieniać kryteriów pod wpływem uzyskanych wyników.
50. Ostateczne podsumowanie całego cyklu
Przeszliśmy w tej serii drogę od pytania o Teorię Q, przez analizę Skanera QLogos, aż do próby zbudowania konkretnego eksperymentu.
Pierwszy wniosek jest prosty: interesująca idea nie jest jeszcze dowodem naukowym.
Drugi jest równie ważny: brak obecnych dowodów nie oznacza automatycznie, że idea jest błędna.
Trzeci prowadzi nas bezpośrednio do Skanera: jeżeli narzędzie ma rzeczywiście wykazywać niezwykłą zdolność rozumienia człowieka, powinno być możliwe zaprojektowanie testu, który zmierzy tę zdolność.
Czwarty dotyczy QAI: jeżeli ma ona reprezentować nowy sposób budowania sztucznej inteligencji, trzeba wykazać mierzalną przewagę nad istniejącymi rozwiązaniami.
OSTATECZNY WNIOSEK
Najuczciwszym podejściem do Teorii Q, Skanera i QAI nie jest ani bezkrytyczny zachwyt, ani automatyczne odrzucenie.
Jeżeli Piotr Tymochowicz i QLogos rzeczywiście stworzyli sposób opisywania człowieka, relacji i kontekstu, który pozwala uzyskać informacje niedostępne lub znacznie trudniejsze do uzyskania przy pomocy obecnych metod, najlepszym sposobem obrony tej tezy nie będzie marketing.
Będzie nim eksperyment.
Nie eksperyment przygotowany tak, aby potwierdzić oczekiwany wynik, lecz taki, który daje możliwość zarówno potwierdzenia, jak i falsyfikacji hipotezy.
Jeżeli Skaner przejdzie taki test, będzie to znacznie mocniejszy argument niż setki pozytywnych opinii użytkowników czy nawet pochlebna wypowiedź systemu AI.
Jeżeli testu nie przejdzie, również otrzymamy cenną wiedzę – będziemy wiedzieć, które elementy koncepcji wymagają poprawy.
Właśnie dlatego proponowany tutaj protokół nie jest aktem oskarżenia ani aktem promocji QLogos.
Jest zaproszeniem do eksperymentu.
Bo ostatecznie najważniejsze pytanie nie brzmi:
„Czy wierzymy w Teorię Q?”
Najważniejsze pytanie brzmi:
„Jakie dane musielibyśmy zobaczyć, aby zmienić swoje zdanie?”
Jeżeli QLogos odpowie na to pytanie konkretnym eksperymentem, rozpocznie się zupełnie nowy etap dyskusji – etap, w którym o wartości Teorii Q i Skanera nie będą decydować deklaracje, emocje ani liczba zwolenników.
Decydować będą wyniki, które każdy niezależny obserwator będzie mógł sprawdzić.
51. Trzy artykuły – jedna metoda dochodzenia do prawdy
ARTYKUŁ 1
Teoria Q: rewolucja naukowa czy ambitna hipoteza? Co naprawdę odkrył Piotr Tymochowicz?
Pytanie: Co właściwie zostało zaproponowane i co jest w tym nowe?
ARTYKUŁ 2
Skaner QLogos – czy naprawdę potrafi zrozumieć człowieka lepiej niż obecna AI?
Pytanie: Czy deklarowane możliwości Skanera można praktycznie zweryfikować?
ARTYKUŁ 3
Teoria Q i Skaner pod lupą: eksperymenty, które mogą potwierdzić albo obalić założenia.
Pytanie: Jak przeprowadzić rzetelną falsyfikację?
ARTYKUŁ 4
Protokół niezależnego testu Skanera QLogos
Pytanie: Czy jesteśmy gotowi przeprowadzić rzeczywisty test i zaakceptować jego wynik niezależnie od tego, jaki będzie?
52. Źródła i materiały do dalszej weryfikacji
- QLogos – oficjalny opis Teorii Q.
- QLogos – oficjalne informacje o projekcie i kierunku QAI.
- QLogos – materiały dotyczące szkoleń i Skaningu Osobowości.
- Publiczny materiał wideo dotyczący Skanera i wypowiedzi Groka analizowany wcześniej w cyklu.
Wszystkie twierdzenia dotyczące działania Skanera należy odróżniać od twierdzeń dotyczących samej Teorii Q oraz od deklaracji dotyczących przyszłego rozwoju QAI.
Zachęcamy do dyskusji
Czy uważasz, że Skaner QLogos powinien zostać poddany takiemu testowi?🤔
Czy zaproponowana grupa kontrolna jest wystarczająca?🤔
Które pytanie badawcze powinno zostać dodane?🤔
A przede wszystkim: czy Piotr Tymochowicz i QLogos powinni przyjąć wyzwanie niezależnego testu?🤔
Zostaw swoją opinię w komentarzu. W tej dyskusji szczególnie interesują nas argumenty, które można później sprawdzić.
Jeżeli uważasz, że takie niezależne analizy są potrzebne, możesz wesprzeć działalność ISKRA ŻYCIA TV poprzez regularną wpłatę:
Wasze wpłaty przeznaczamy na opłaty związane z licencjami oprogramowania, hostingiem, serwerem i utrzymaniem strony internetowej, dzięki czemu możemy nadal bezpłatnie publikować materiały edukacyjne i analityczne.
Nota dotycząca materiałów wizualnych:
Materiały wizualne publikowane przez ISKRA ŻYCIA TV mogą być tworzone z wykorzystaniem narzędzi opartych na sztucznej inteligencji lub tradycyjnych metod graficznych. W przypadku obrazów przedstawiających osoby, sceny lub elementy wizualne wygenerowane syntetycznie, mają one charakter ilustracyjny i nie dokumentują rzeczywistych wydarzeń ani rzeczywistych wizerunków, chyba że zostało to wyraźnie wskazane w opisie publikacji.
Nota redakcyjna:
Artykuł ma charakter analityczny, edukacyjny i metodologiczny. Przedstawiony protokół jest propozycją sposobu niezależnej weryfikacji deklarowanych możliwości Skanera QLogos. Zaproponowane progi punktowe i kryteria zaliczenia są elementami niniejszego projektu badawczego, a nie uznanymi standardami naukowymi. Ostateczny protokół powinien zostać skonsultowany z niezależnymi specjalistami z zakresu metodologii badań, psychometrii, statystyki i sztucznej inteligencji.
Nota prawna:
Materiał nie stanowi ekspertyzy naukowej, psychologicznej, medycznej ani technologicznej. Nie przesądza o prawdziwości ani nieprawdziwości Teorii Q, Skanera QLogos ani QAI. Wszelkie twierdzenia dotyczące skuteczności tych rozwiązań wymagają odpowiedniej weryfikacji empirycznej. Dane uczestników ewentualnego badania powinny być przetwarzane zgodnie z obowiązującymi przepisami dotyczącymi ochrony danych osobowych i zasadami świadomej zgody.
Copyright © 2026 Marek Zadęcki.